Onde o dinheiro vai
Num agente que conversa por vários turnos, cada chamada à API reenvia as instruções, as definições de ferramentas e o histórico. Sem cache, a empresa paga esse mesmo prefixo inteiro em todas as chamadas. Com prompt caching, a Anthropic e a OpenAI cobram a releitura do prefixo por uma fração do preço de entrada. O desconto só aparece se o prompt for montado do jeito certo. As duas documentações descrevem erros de montagem que derrubam a economia, e alguns deles não geram erro nenhum na resposta.
Os multiplicadores das duas APIs (outubro de 2026)
Anthropic (Claude):
- Gravação no cache com validade de 5 minutos: 1,25 vez o preço normal de entrada.
- Gravação com validade de 1 hora: 2 vezes.
- Leitura do cache: 0,1 vez na maioria dos modelos, 0,05 vez no Claude Opus 5.5 e no Claude Sonnet 5.5, 0,025 vez no Claude Fable 5.1 e no Claude Mythos 5.1.
- A validade de 5 minutos se renova sem custo cada vez que o prefixo é lido.
OpenAI (GPT-5.6 e posteriores):
- Gravação com validade mínima de 30 minutos, que é o padrão: 1,25 vez o preço normal de entrada.
- Gravação com validade de 12 horas, disponível na Responses API: 2,5 vezes.
- Leitura: 0,1 vez na maioria desses modelos e 0,05 vez no GPT-6.1 Sol e no GPT-6.1 Terra.
- Nos modelos anteriores ao GPT-5.6 não existe cobrança extra de gravação. A leitura segue o preço de entrada em cache de cada modelo.
A conta que interessa
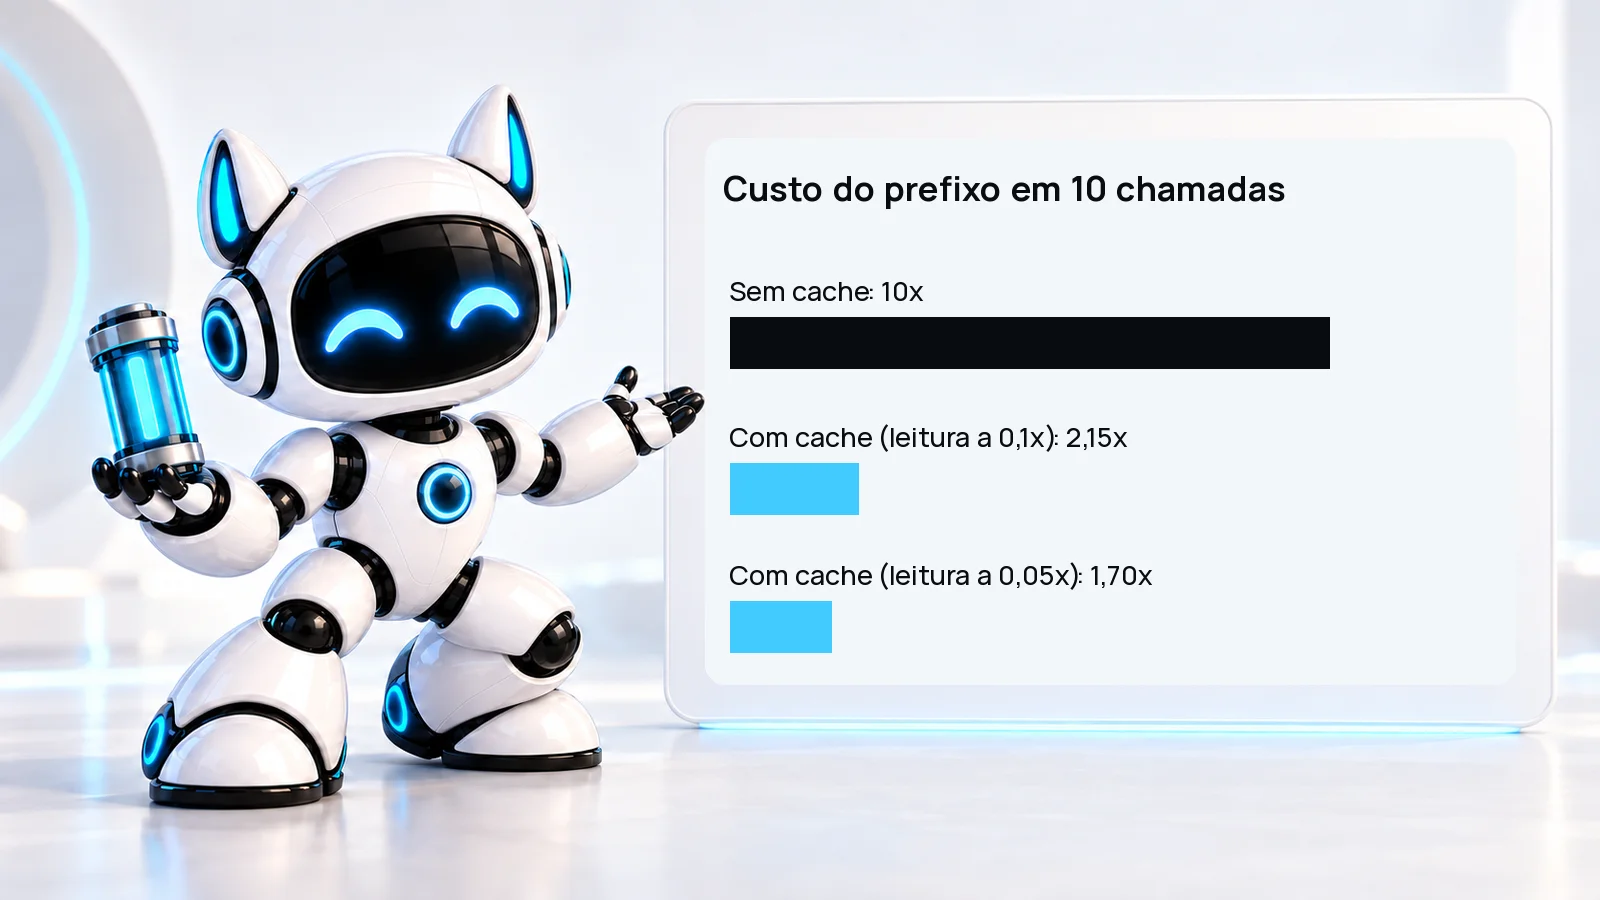
A própria OpenAI publica a conta: com leitura a 0,1 vez e gravação de 30 minutos, gravar um prefixo uma vez e reaproveitá-lo nove vezes custa 2,15 vezes o preço desse prefixo, contra 10 vezes sem cache. Na Anthropic, com gravação de 5 minutos e leitura a 0,1 vez, a mesma sequência também dá 2,15 (1,25 + 9 x 0,1). Nos modelos com leitura a 0,05 vez, cai para 1,70.
Um exemplo de cálculo com a tabela da Anthropic: um agente de atendimento tem 20.000 tokens fixos de instruções e ferramentas e faz 10 chamadas no Claude Sonnet 5.5, com menos de 5 minutos entre uma e outra. A entrada desse modelo custa US$ 2 por milhão de tokens. Sem cache, o prefixo custa US$ 0,40 nessas 10 chamadas. Com cache, custa US$ 0,05 na gravação e US$ 0,018 nas nove leituras, total de US$ 0,068. A redução no custo do prefixo é de 83%. A saída e os tokens novos de cada turno continuam com preço normal.
Sete erros que zeram o desconto
- Marcar o cache no bloco que muda. Na Anthropic, se o ponto de cache (o campo cache_control) fica no bloco que traz data, hora ou a mensagem do usuário, cada chamada grava um cache novo e nunca lê nenhum. A documentação manda colocar o ponto no último bloco que fica idêntico entre as chamadas. Na OpenAI, a partir do GPT-5.6, o modo implícito tem o mesmo problema quando o conteúdo fixo vem seguido de conteúdo variável. A correção indicada é um breakpoint explícito (prompt_cache_breakpoint) logo depois do conteúdo fixo.
- Prefixo abaixo do mínimo. Na Anthropic o mínimo vai de 512 tokens (Claude Opus 5.5, Sonnet 5.5, Haiku 5.5 e outros) a 4.096 tokens (Claude Opus 4.6, Opus 4.5 e Haiku 4.5). Abaixo disso a API não guarda o cache e não devolve erro. Na OpenAI, o mínimo é de 1.024 tokens visíveis no GPT-5.6 e posteriores. As duas documentações sugerem completar o prefixo com instruções ou exemplos úteis quando ele fica logo abaixo do mínimo.
- Mudar as ferramentas no meio da conversa. Na Anthropic, alterar nome, descrição ou parâmetros de uma ferramenta invalida o cache inteiro. Na OpenAI, a orientação é manter a lista de ferramentas estável e usar tool_choice com valor "none" ou allowed_tools em vez de remover definições.
- Trocar o esforço de raciocínio entre chamadas. Na Anthropic, mudar a configuração de thinking ou o valor de effort invalida o cache das mensagens. Na OpenAI, os modelos GPT-6 aceitam um item configuration_update no fim do input para mudar o esforço sem reescrever o prefixo, mantendo o reasoning.effort do topo igual.
- Disparar chamadas em paralelo antes da primeira responder. Na Anthropic, o cache só fica disponível depois que a primeira resposta começa. Para várias chamadas simultâneas com o mesmo prefixo, a documentação manda esperar a primeira resposta antes de enviar as demais.
- Separar times em workspaces sem considerar o cache. Na API da Anthropic o cache é isolado por workspace. Dois times com o mesmo prompt em workspaces diferentes pagam a gravação cada um.
- Contar com o cache para fugir do limite de taxa sem conferir a regra. Na Anthropic, leituras de cache não descontam do rate limit. Na OpenAI, tokens em cache continuam contando no limite de tokens por minuto.
Como conferir se está funcionando
Na Anthropic, cada resposta traz no campo usage três números: cache_creation_input_tokens (tokens gravados), cache_read_input_tokens (tokens lidos do cache) e input_tokens (o que veio depois do último ponto de cache). Se os dois primeiros vierem zerados, o prompt não foi cacheado. Na OpenAI, os campos são usage.input_tokens_details.cached_tokens e usage.input_tokens_details.cache_write_tokens. A OpenAI recomenda calcular a taxa de acerto dividindo o total de tokens em cache pelo total de tokens de entrada, agrupado por usuário, workspace ou dia.
Qual validade escolher
Na Anthropic, se o prefixo é reutilizado com intervalo menor que 5 minutos, a validade padrão basta, porque ela se renova de graça a cada leitura. A de 1 hora compensa quando o intervalo fica entre 5 minutos e 1 hora, como num subagente que leva mais de 5 minutos ou numa conversa em que o cliente demora para responder. Na OpenAI, a documentação indica 30 minutos para contexto reaproveitado com frequência e 12 horas para instruções e material de referência estáveis usados ao longo do dia.
Onde isso entra no seu projeto
A economia depende de como o agente monta o prompt: o que é fixo, o que muda e em que ordem cada parte entra. Essa revisão de prefixo, pontos de cache e taxa de acerto faz parte do diagnóstico de operação que a LC Labs conduz antes de colocar um agente em produção.
Fontes
- Anthropic, documentação "Prompt caching": https://docs.anthropic.com/en/docs/build-with-claude/prompt-caching (abre em nova aba) (consultada em 28/10/2026)
- OpenAI, guia "Prompt caching": https://platform.openai.com/docs/guides/prompt-caching (abre em nova aba) (consultada em 28/10/2026)